

Interdyscyplinarne Pomorskie Centrum Medycyny Cyfrowej (IP_CMC) przechowuje dane pochodzące z różnych źródeł, w tym ze szpitali, rejestrów i zasobów publicznych oraz badań prowadzonych na Gdańskim Uniwersytecie Medycznym (GUMed). Wszystkie dane udostępniane w ramach infrastruktury IP_CMC są zanonimizowane, dzięki czemu mogą być wykorzystywane w badaniach naukowych z zachowaniem wysokich standardów bezpieczeństwa i ochrony prywatności.
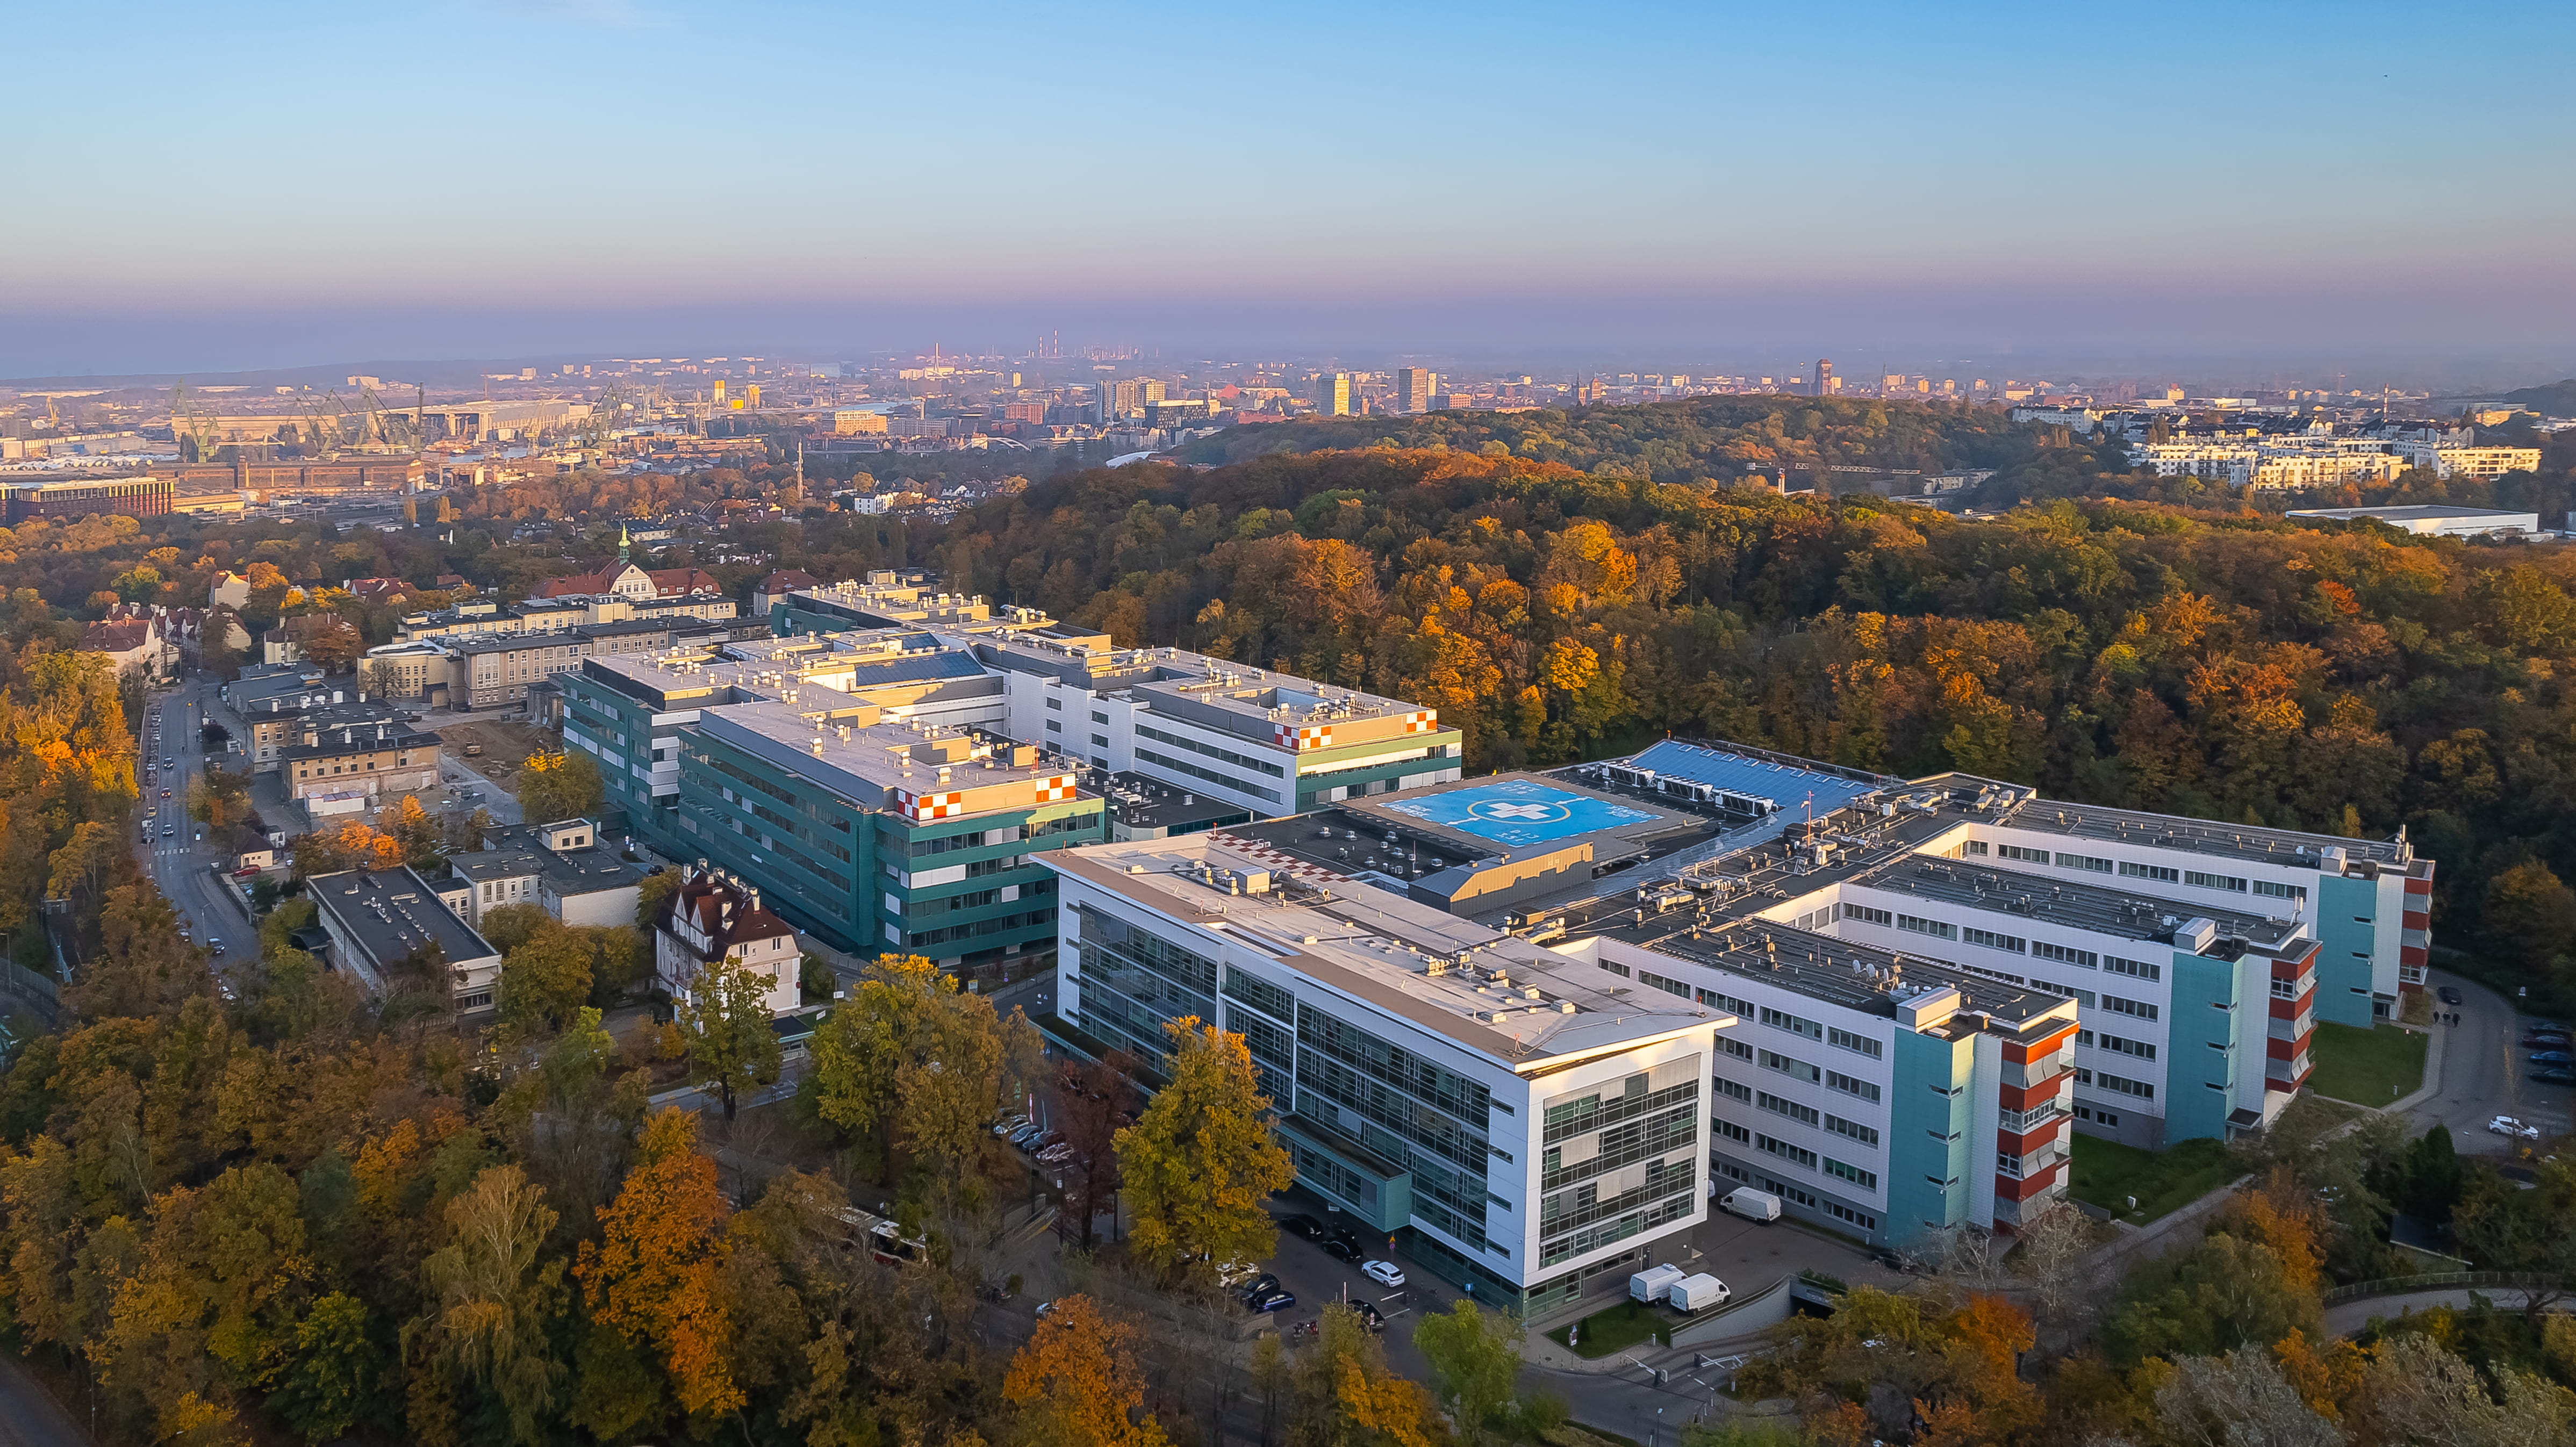
Uniwersytecki Szpital Kliniczny
Uniwersyteckie Centrum Kliniczne (UCK) w Gdańsku to szpital kliniczny GUMedu oraz jeden z największych i najnowocześniejszych wysokospecjalistycznych szpitali w Polsce. Jest ważnym ośrodkiem klinicznym, dydaktycznym i badawczym, zapewniającym szeroki dostęp do danych powstających w codziennej praktyce medycznej.
W 2024 roku w UCK odnotowano 143 323 hospitalizacje, bez uwzględnienia pobytów dziennych, wykonano 4 600 000 badań laboratoryjnych i 238 839 diagnostycznych, a także udzielono 493 483 porad specjalistycznych. Skala działalności szpitala sprawia, że jest to najważniejsze źródło danych klinicznych w zasobach IP_CMC.
Dane pozyskiwane z UCK obejmują przede wszystkim dane kliniczne i laboratoryjne pochodzące z systemu HIS, a także dane obrazowe. Zbiory te są porządkowane wokół kluczowych encji opisujących przebieg opieki nad pacjentem:
- pacjent – podstawowe informacje demograficzne, np. wiek, płeć;
- Hospitalizacje – informacje o czasie trwanie, trybie przyjęcia i wypisu, a także pobytach szpitalnych;
- Wizyty ambulatoryjne – dane dotyczące świadczeń realizowanych w trybie ambulatoryjnym, konsultacji i kontroli specjalistycznych;
- Diagnozy – rozpoznania medyczne dokumentowane w trakcie hospitalizacji i wizyt;
- Procedury medyczne – informacje o wykonanych procedurach diagnostycznych, terapeutycznych i zabiegowych;
- Podania leków – dane o farmakoterapii, w tym o ordynacji i realizacji podań leków w toku leczenia;
- Wyniki laboratoryjne i opisowe – wyniki badań laboratoryjnych oraz opisy badań i konsultacji wspierające analizę przebiegu diagnostyki.
- Obserwacje z dokumentacji opisowej – informacje wyodrębniane z nieustrukturyzowanej dokumentacji medycznej, pozwalające uchwycić dane niewystępujące w polach strukturalnych.
- Dane obrazowe – zasoby diagnostyki obrazowej, które mogą być wykorzystywane między innymi w analizach ilościowych oraz rozwoju metod sztucznej inteligencji.
Centralny Biobank GUMed
Centralny Biobank GUMed to jednostka Gdańskiego Uniwersytetu Medycznego prowadząca kompleksową obsługę próbek biologicznych — przede wszystkim na potrzeby projektów naukowych i badań klinicznych realizowanych przez badaczy Uczelni. Do jej zadań należą przyjmowanie i rejestracja materiału biologicznego, jego przetwarzanie zgodnie ze standardowymi procedurami zapewniającymi wysoką jakość i powtarzalność procesów biobankowania, a także bezpieczne, długoterminowe przechowywanie próbek w warunkach niskotemperaturowych. Infrastruktura Biobanku obejmuje m.in. system monitorowania temperatury i warunków środowiskowych oraz powiadomienia alarmowe, co pozwala czuwać nad stabilnością przechowywania i integralnością zgromadzonego materiału. Poza samym przechowywaniem jednostka wspiera zespoły badawcze w organizacji procesu gromadzenia próbek oraz w porządkowaniu i elektronicznym ewidencjonowaniu kolekcji.
W ramach realizowanego projektu pobrano próbki od 100 dawców uczestniczących w badaniach dotyczących rzadkich chorób pediatrycznych. Próbki te są przechowywane w Centralnym Biobanku GUMed, gdzie wykonano również ekstrakcję materiału genetycznego — a uzyskana sekwencja genetyczna jest przechowywana w zasobach IP_CMC i stanowi podstawę do dalszych analiz.
Zbiór ten uzupełniają bogate dane ankietowe zebrane od dawców, obejmujące m.in.:
- dane demograficzne,
- informacje o chorobach przewlekłych i nowotworowych,
- przyjmowane leki,
- używki i uzależnienia,
- aktywność (np. fizyczną),
- historię rodzinną.
Modele danych w IP_CMC
Jednym z kluczowych zadań Interdyscyplinarnego Pomorskiego Centrum Medycyny Cyfrowej jest integrowanie danych z różnych źródeł i udostępnianie ich badaczom w wygodnej, gotowej do analiz formie. Aby pogodzić te dwa cele — elastyczne przyjmowanie danych z jednej strony i przyjazny dostęp dla naukowców z drugiej — nasze repozytorium danych (Data Lakehouse) zbudowaliśmy w oparciu o architekturę medalionową.
Architektura medalionowa porządkuje dane w trzech kolejnych warstwach — Bronze, Silver i Gold — z których każda odpowiada innemu etapowi przetwarzania i innemu modelowi danych. Dane „wędrują" przez te warstwy, stopniowo zyskując na uporządkowaniu, standaryzacji i gotowości do analiz.
Warstwa Bronze — model wejściowy. To warstwa przyjmowania danych w postaci możliwie zbliżonej do źródłowej. Dane trafiają tu w autorskim modelu wejściowym IPCMC, celowo zaprojektowanym tak, aby był prosty — dzięki czemu dostawcy danych mogą bez trudu dostosować się do jego wymagań i sprawnie przekazać swoje zasoby do Centrum.
Warstwa Silver — model natywny (HL7 FHIR). Tu dane są ujednolicane i integrowane w modelu natywnym opartym na standardzie HL7 FHIR. Warstwa ta umożliwia łączenie danych z różnych źródeł oraz opisywanie ich za pomocą różnych kodyfikacji medycznych. Docelowo model ten ma również pełnić rolę standardu wymiany danych między Regionalnymi Centrami Medycyny Cyfrowej (RCMC).
Warstwa Gold — model analityczny (OMOP CDM). Najwyższa warstwa zawiera dane w modelu analitycznym opartym na OHDSI OMOP CDM. Zapewnia on dane w płaskiej, uporządkowanej strukturze, wygodnej do prowadzenia analiz naukowych — to z tej warstwy korzystają badacze przy pracy z gotowymi zbiorami danych.
Czym jest HL7 FHIR? HL7 FHIR (Fast Healthcare Interoperability Resources) to nowoczesny, międzynarodowy standard elektronicznej wymiany danych medycznych, rozwijany przez organizację HL7. Opisuje informacje kliniczne w postaci spójnych, wielokrotnie używalnych „zasobów" (resources) — takich jak pacjent, obserwacja, lek czy wynik badania — i jest dziś powszechnie stosowany do zapewniania interoperacyjności, czyli sprawnej komunikacji między różnymi systemami informatycznymi w ochronie zdrowia. Dzięki temu dane z odmiennych źródeł można łączyć i wymieniać we wspólnym, zrozumiałym formacie.
Czym jest OHDSI OMOP CDM? OMOP CDM (Observational Medical Outcomes Partnership Common Data Model), rozwijany przez społeczność OHDSI, to otwarty standard organizacji danych medycznych na potrzeby analiz i badań obserwacyjnych. Sprowadza dane z różnych systemów do jednej, wspólnej struktury tabel oraz ujednoliconych słowników (m.in. SNOMED CT, LOINC, RxNorm). Jego siłą jest powtarzalność analiz — kod napisany raz można uruchomić na dowolnym zbiorze zgodnym z OMOP, także w innych ośrodkach — co czyni go standardem szczególnie dobrze dopasowanym do badań naukowych i wieloośrodkowych.
Jeżeli chcesz dowiedzieć się więcej na temat różnych standardów i modeli danych, zapoznaj się z jedną z naszych prezentacji:
- OHDSI i HL7 FHIR jako przykładowe standardy danych medycznych: https://www.researchgate.net/publication/385001481_OHDSI_i_HL7_FHIR_jako_przykladowe_standardy_danych_medycznych
- Koncepcja mapowania danych źródłowych systemu HIS i danych obrazowych do standardu FHIR: https://www.researchgate.net/publication/385007245_Koncepcja_mapowania_danych_zrodlowych_systemu_HIS_i_danych_obrazowych_do_standardu_FHIR