

Leaf — samodzielne budowanie kohort pacjentów
W Interdyscyplinarnym Pomorskim Centrum Medycyny Cyfrowej wdrożyliśmy Leaf — otwarte (open-source) narzędzie do interaktywnego budowania kohort pacjentów. Dzięki niemu badacze mogą samodzielnie, bez znajomości SQL i bez pośrednictwa zespołu IT, przeszukiwać zasoby danych klinicznych i w kilka chwil zdefiniować grupę pacjentów spełniających interesujące ich kryteria — na przykład rozpoznania, wyniki badań laboratoryjnych, przyjmowane leki, wykonane procedury czy dane demograficzne.
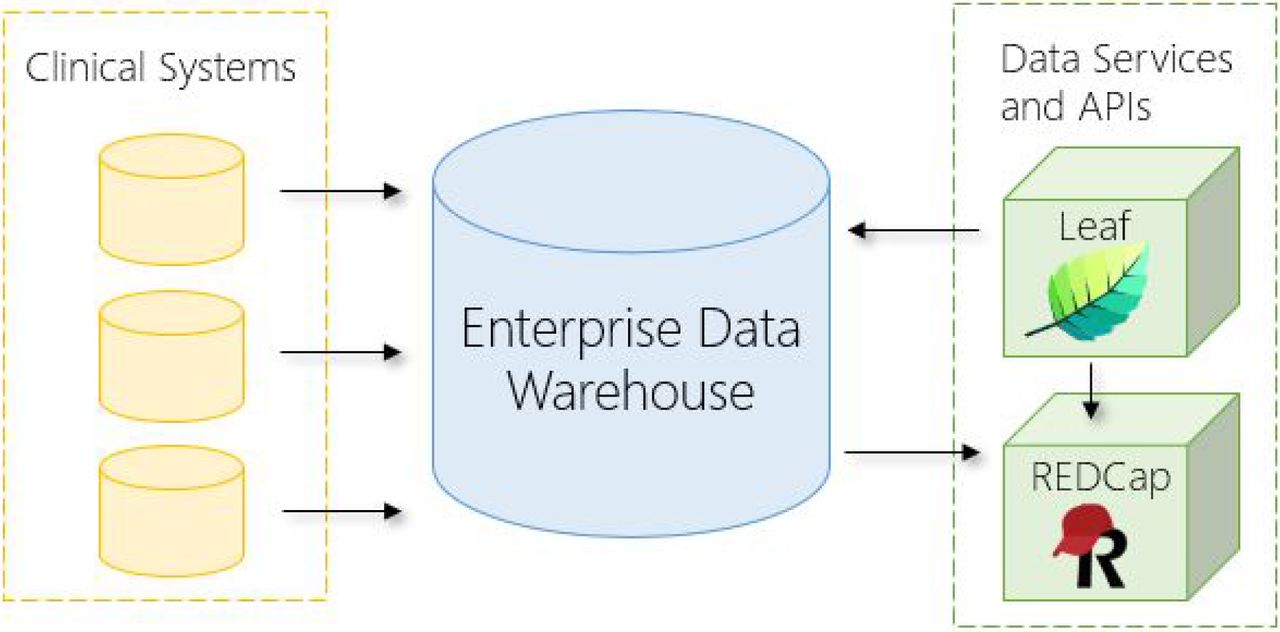
Architektura integracji Leaf z hurtownią danych (Enterprise Data Warehouse) i systemem REDCap. Źródło: JAMIA, 2020.
Najważniejsze zalety
- Intuicyjny interfejs wizualny — kohortę buduje się „klikając", stopniowo zawężając kryteria i natychmiast widząc liczebność grupy.
- Samoobsługowość — badacz pracuje niezależnie, co skraca czas od pomysłu do oceny wykonalności badania (feasibility).
- Niezależność od modelu danych — Leaf jest „model-agnostic", więc działa na różnych strukturach danych (m.in. OMOP CDM, i2b2) i można go podłączyć do istniejącej hurtowni danych.
- Bezpieczeństwo i kontrola dostępu — zapytania podlegają uprawnieniom, a na etapie eksploracji wyniki mają charakter zagregowany.
- Otwartość — jako projekt open-source Leaf może być swobodnie rozwijany i dostosowywany do lokalnych potrzeb.
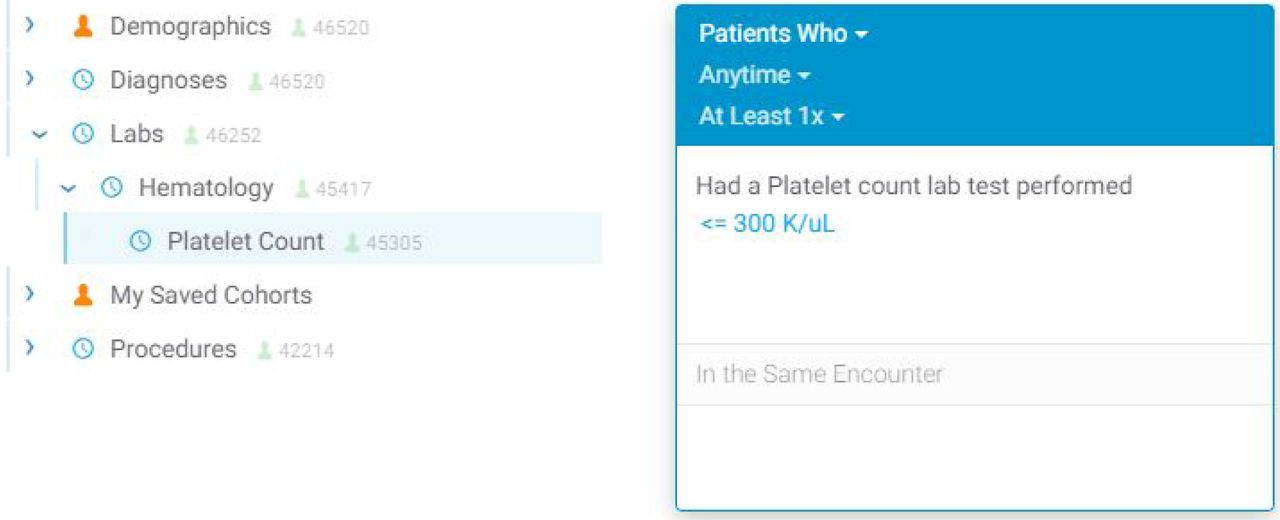
Interfejs Leaf — drzewo kryteriów klinicznych i panel definiowania kohorty pacjentów. Źródło: JAMIA, 2020.
Dodatkowe możliwości Leaf
- Wizualizacja danych w czasie rzeczywistym: Leaf pokazuje natychmiastowy podział demograficzny zdefiniowanej kohorty (m.in. wiek, płeć, pochodzenie etniczne, stan życiowy) w formie interaktywnych wykresów.
- Zapytania czasowe: pozwala precyzyjnie określać kolejność i odstępy czasowe między zdarzeniami klinicznymi (np. „wynik badania laboratoryjnego X w ciągu 30 dni od podania leku Y").
- Anonimizacja danych: na etapie eksploracji Leaf usuwa bezpośrednie identyfikatory pacjenta i może stosować przesunięcie dat, dodatkowo chroniąc dane osobowe.
- Eksport wyników: zdefiniowaną, zanonimizowaną listę pacjentów można pobrać w formacie CSV lub wyeksportować bezpośrednio do REDCap na potrzeby dalszych etapów badania.
Domeny danych dostępne do wyszukiwania
- Schorzenia: diagnozy kodowane i opisowe (np. kody ICD-10).
- Zabiegi: zabiegi kliniczne, operacje, usługi i zdarzenia diagnostyczne.
- Dane demograficzne: wiek pacjenta, pochodzenie etniczne, płeć, rasa i stan życiowy.
- Wizyty: rodzaje wizyt, szczegóły przyjęcia oraz kryteria pobytu pacjenta.
- Parametry życiowe: podstawowe pomiary stanu zdrowia (ciśnienie krwi, BMI, tętno).
- Wyniki badań laboratoryjnych: panele badań laboratoryjnych, pomiary ankietowe i obserwacje.
- Leki: recepty, podawanie leków pacjentom hospitalizowanym oraz zlecenia.
- Specjalistyczne zbiory danych: np. metadane obrazowania (imaging warehouse) oraz kohorty próbek z biobanku.
Leaf na świecie
Narzędzie powstało na University of Washington (UW Medicine, Institute of Translational Health Sciences) i jest rozwijane jako projekt open-source, opisany w recenzowanym czasopiśmie JAMIA (Journal of the American Medical Informatics Association, 2020). Jest wykorzystywane w licznych akademickich ośrodkach medycznych, przede wszystkim w sieci amerykańskich centrów CTSA (Clinical and Translational Science Awards), gdzie służy do samoobsługowej eksploracji danych klinicznych i oceny wykonalności badań. Rozwój Leaf jest wspierany m.in. grantem NIH UL1TR004419, przyznanym przez National Center for Advancing Translational Sciences (NCATS).
Dostęp do kodu źródłowego
Leaf jest projektem open-source udostępnionym na licencji MPL-2.0. Kod źródłowy dostępny jest na GitHubie pod adresem github.com/uwrit/leaf (link otworzy się w nowej karcie).
Materiały szkoleniowe
Jeżeli chcesz dowiedzieć się więcej, zapoznaj się z naszą prezentacją i filmem szkoleniowym:
- Prezentacja szkoleniowa Leaf
- Nagranie szkolenia Leaf (dostęp po zalogowaniu kontem GUMed)